研究摘要
知识图谱使信息所指的身份、关系和情境得到明确表达。它的实际价值在于连接原本分散的记录,说明这些连接意味着什么,并保留解释它们所需的证据。当使用者能够判断一项陈述涉及哪个实体、来自何处、在何时适用,以及可以据此合理得出什么结论时,图谱才成为有用的知识基础设施。仅凭一张视觉上引人注目的网络图,无法确立这些性质。
本报告把知识图谱作为一个贯通研究与工程的整体来考察,连接模式设计、实体抽取、关系抽取、知识存储、图计算、知识推理、应用与人工智能智能体。核心观点是:系统的可靠表现依赖这些阶段之间的一致约定。抽取模型无法修复含糊的身份政策;高速数据库不能使没有依据的关系变成事实;如果图谱缺少权限、时间戳或证据状态,智能体就无法安全地据此行动。
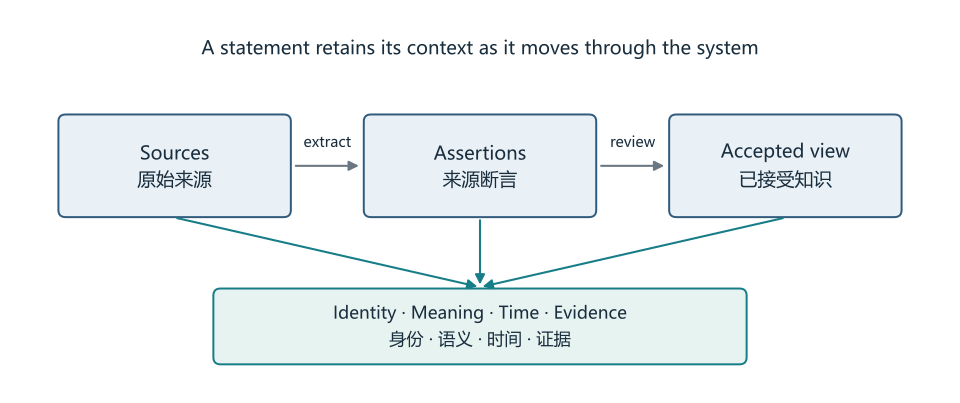
分析围绕三项区别展开。第一,文档中的一次提及不同于它所指的实体。第二,来源中的断言不同于已接受的事实,也不同于模型预测。第三,图算法、逻辑证明与因果结论回答的是不同问题。明确这些区别,有助于改进系统设计,避免夸大知识图谱“理解”了什么;它们也解释了为何将所有内容存成不加区分的三元组集合,往往不能产生预期效果。
报告结合叙述性文献综述、原创架构分析与合成计算示例。基础综述提供领域定位,标准确立形式语义,原始研究论文说明具体方法。研究使用 Consensus 和 SciSpace 发现文献线索,随后核对原始发表记录与可访问的论文页面,并使用 Wolfram 验证一个小型 PageRank 计算。检索索引对年份或作者姓名有时存在分歧,因此在条件允许时,参考文献优先采用可识别的正式发表版本。证据检索日期为2026年10月1日。本报告是选择性的整合综述,并非穷尽式系统综述,也不是新的基准实验。
近期关于图谱检索增强生成和图谱引导智能体的研究,展示了结构化知识与语言模型结合的若干可行方式。对于需要明确连接、来源追溯或受控更新的问题,现有证据支持进一步研究这些组合,但不足以认定加入图谱总能改善检索系统。建图错误、检索扩展、过时摘要与额外处理成本,可能抵消收益。因此,严格评价应在相同语料、模型、访问政策和成本预算下,把图谱方法与更简单的替代方案进行比较。
原创案例“研究证据图谱”贯穿全文,连接文档、主张、人物、方法、数据集与实验。除非正文明确指向真实出版物,案例中的人物、机构、日期与实验记录均为虚构。该案例说明如何让图谱支持研究助手,同时避免将作者的主张误认为独立确认的事实;它也展示了从小型本地项目发展到有治理机制的组织系统的实践路径。
阅读指南
第1、2章解释知识图谱的含义与模式;第3至6章讨论构建与存储;第7、8章区分计算与推理;第9至11章考察应用、语言模型与智能体;第12至14章讨论评价、实施与研究重点。英文原稿在术语首次出现时及术语表中提供中文注释;本中文版对正文作完整翻译,并保留必要的英文术语。图示为原创解释性示意,数值案例来自合成计算,不是实证发现。方括号中的编号对应参考文献。