13.1 范围与虚构来源集合
本章为小型研究团队提出原创实现设计,目标是在保留来源并允许纠正的条件下,回答检索方法的证据问题。起始集合由三份虚构文档和少量明确编造的记录组成,规模刻意保持到可人工检查。后续可以扩展,但首先应让每次变换都可理解、可测试。
文档P1日期为2025年2月,报告GraphLens与PathSearch在数据集D版本1上的评价;P2日期为2025年5月,在D版本2上重复比较,得到不同结果;P3日期为2025年6月,更正P1的一个元数据字段,并指出一项得分使用了不同查询子集。这些都不是真实出版物,使用虚构名称是为了避免把案例误认为真实方法的实证主张。
能力问题必须具体:哪些结果比较相同数据集版本和指标下的两种方法?哪个主张依赖被更正的查询子集?哪些来源支持改进陈述,哪些条件使结果不能直接比较?系统应附来源回答;除非聚合政策和可比证据支持,否则不应给出总体胜者。
13.2 最小模式与记录
最小模式包含Document、SourceSpan、Person、Method、Dataset、Evaluation和Claim。文档有本地标识、标题、版本、日期和内容哈希;来源片段有定位及文档版本引用;评价连接比较方法、数据集版本、指标与报告测量;主张表达解释后的结果,并连接相关评价及来源证据。审核状态属于主张记录,书目身份属于文档。
合成测量采用规定查询集上的平均倒数排名。P1报告D版本1上GraphLens为0.42、PathSearch为0.38;P2报告D版本2上分别为0.40与0.41。这些编造数值支持两项限定情境的比较,却不能在不考虑查询集、不确定性和评价协议时直接平均。P3更正进一步凸显了可比性问题。
| 文档 | 数据集 | GraphLens | PathSearch | 情境 |
|---|---|---|---|---|
| P1 | D版本1 | 0.42 | 0.38 | 查询子集后来由P3加以限定 |
| P2 | D版本2 | 0.40 | 0.41 | 不同评价情境 |
| P3 | 更正 | — | — | 修订对P1的解释 |
对于P1,图谱可存储“在所述评价条件下,GraphLens报告得分更高”这一归属于来源的主张,不能存成“GraphLens普遍优于PathSearch”。P2则保留另一数据集版本下的结果。比较视图并列显示两种情境及更正说明。图谱价值是保留解释分歧所需的结构,而非强行把文档压成一条不带限定的边。
13.3 导入与验证
导入先保存不可变来源版本并解析文档结构,识别候选实体,链接本地方法与数据集登记库,再输出带来源定位和明确缺失字段的候选评价。不能凭一般知识补造置信区间或查询数。验证器检查标识、数值类型、关系方向及必需情境。
首轮人工审核聚焦比较含义与更正范围:P3改变了数值、适用人群,还是只改描述字段?区别决定哪些记录需要修订。若更正影响可比性却不改变原始测量,应保留原结果并增加限定;删除整个结果会丢失历史,并夸大更正的影响。
已接受发布获得快照标识和简短清单,列出来源版本、模式版本、抽取配置与审核决策。搜索索引和生成摘要均记录该快照。后续重处理可以提出变化,而不改变当前已接受视图,使模型实验与用户持续研究所需的稳定基础共存。
13.4 查询已接受证据
有界查询可以检索指定数据集关联的已接受主张及来源片段。以下Cypher示例说明属性图实现的预期模式,假定采用刚才描述的模式并绑定数据集标识参数。它是教学示例,并非在用户已有数据库上执行的命令。本报告不涉及数据库凭据、部署路径或私人记录。
MATCH (c:Claim {status: 'accepted'})-[:BASED_ON]->(e:Evaluation)
      -[:USES_DATASET]->(d:Dataset {id: $dataset_id})
MATCH (c)-[:EVIDENCED_BY]->(s:SourceSpan)-[:IN_DOCUMENT]->(p:Document)
RETURN c.id, c.text, p.id, s.locator
ORDER BY c.id
查询返回证据记录,而非自由生成的结论;呈现层可以一起显示主张、文档和定位。多段来源共同支持同一主张时,应分组显示,不能每段算作一项独立研究。如果权限限制移除了一个来源,系统也不能暗示剩余可见集合已完整,应说明可访问证据的范围与限制。
对应RDF实现可以用IRI和谓词表达相同领域实体,再使用SPARQL图模式;两个版本的语义设计应保持可识别的一致性。案例旨在说明存储选择改变查询语法,却不必改变核心证据约定。转换应检验限定、身份与来源,而不能只看节点数相同。
13.5 智能体交互与纠正
若用户问“GraphLens是否优于PathSearch”,智能体应解析方法身份,检索两次评价和更正,说明虚构证据在不同条件下报告不同结果,并具体指出条件。现有记录不能确立普遍胜者。回答仍可简洁:并列两项结果,说明更正,再指出还需什么比较。
用户提供P3并要求更新图谱时,智能体准备包含受影响主张、证据定位、限定和预期快照的变更建议。验证器检查建议,配置的审核政策决定是否可自动接受。写入记录新状态及来源,依赖摘要被标为过时,并在再次作为当前证据提供前重新生成。
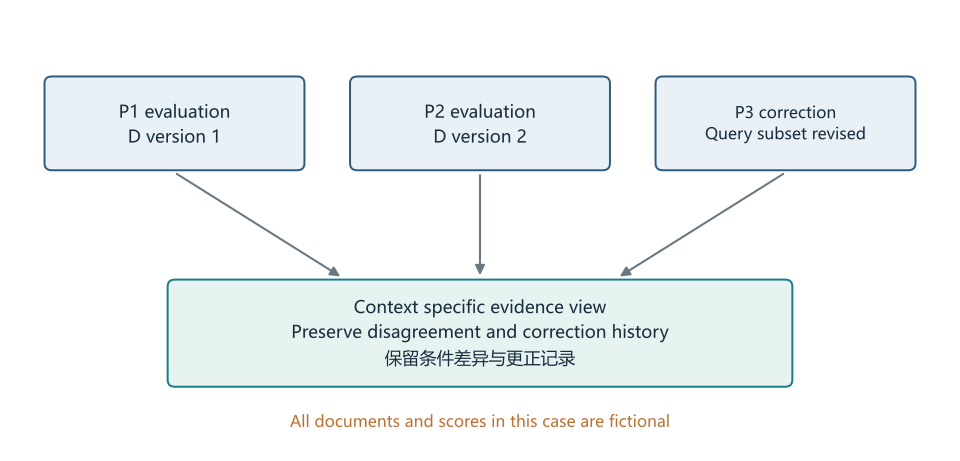
虚构研究证据图谱保留两种评价情境及一次更正,不对真实方法性能作断言。
原图保留中英文标签;请结合正文解释阅读。点击可查看大图。若抽取错误地把GraphLens链接到无关产品,修复应作用于提及到实体的映射,来源保持完整。系统识别依赖错误映射的主张和摘要,修订并记录修复。这说明身份决策为何必须可撤销:如果曾覆盖来源名称并丢弃映射,同样纠正就会困难得多。
13.6 实现测试
首项验收检查身份:P1、P2中的GraphLens归到预期方法,同名无关实体保持分开。第二项检查情境:数据集版本与查询子集不混淆。第三项检查证据:每项接受的比较能定位精确来源。第四项检查更正传播:P3更新相关视图,使依赖摘要失效,却不抹去无关结果。
检索测试同时提出局部事实问题和含糊全局问题。局部问题返回指定得分及情境,全局问题保留分歧、避免无依据排名。访问测试撤销P2权限,验证其直接结果和派生摘要都不泄漏;恢复测试重试中断更新,确认幂等键防止重复。
性能测试应在语义正确之后进行。团队在代表文档上测量导入时间、审核投入、查询延迟和证据包大小,再决定是否增加索引、缓存或更高级检索,使优化针对真实瓶颈。小而可靠的系统,比无法检查正确性的大型演示更适合作为扩展基础。
13.7 分阶段交付计划
第一阶段确定范围、标识、最小模式和人工核验种子集合;第二阶段自动解析与抽取到暂存区,并作审核和错误分析;第三阶段增加有界检索与证据性回答;第四阶段加入受控更新、更正传播和监测。更自主的规划要在前述能力测量后引入。这是按依赖关系组织的阶段,不是固定日历承诺。
每阶段都应有退出标准:种子图能回答能力问题,抽取在留出文档上达到本地质量阈值,检索找到代表问题所需证据,更新保留来源并能从失败恢复。这为本地Neo4j项目提供实施路径,也适用于RDF或其他后端。核心交付是可信证据工作流,数据库为该工作流服务。