7.1 计算能够提供什么
“知识计算”含义较广,本报告将其用于对明确关系进行查询、计算结构性质、学习表示和评价派生度量。这些操作可以揭示有用模式,却不必确立新的逻辑真理。中心性分数可以找出结构上突出的论文,却不能证明论文正确;聚类可以找出连接密集的实体,却不能证明它们属于天然类别。解释取决于建模的关系及所问问题。
任何计算都应先明确图规格:包含哪些节点和边类型,是否考虑方向,如何定义权重、处理重复边,以及覆盖什么时间区间。若把研究图谱中的CITES、CONTRADICTS和AUTHORED_BY混作普通边,就会混合不同意义。分数可能在数学上定义良好,却难以作科学解释。因此,复现分析必须像记录算法一样认真地记录投影。
7.2 遍历 可达性与最短路径
遍历按照规则访问相连记录。广度优先搜索在无权图中寻找以边数度量的最短路径;加权最短路径则在算法假设下使边成本之和最小,解决的是另一问题。成本可以代表旅行时间、处理投入或其他数量,不能仅因图中已有某个数值属性就采用它。
假设依赖图将研究主张连接到它依赖的研究与数据集,可达性可以回答某数据集更正可能影响哪些主张。但可达集合只是潜在受影响记录,不表示每个结论都已无效。审核仍需逐项检查主张如何使用数据集。这样,图算法能够支持决策,而不假装已经完成全部决策。
合成有向图包含A、B、C、D四个节点,边为A→B、A→C、B→C、C→A及D→C。从D到B的最短路径是D→C→A→B,长度为3;A到D则没有有向路径。若画成无向图,会掩盖这种不对称,暗示有向模型不允许的连接。图7保留箭头,使区别可见。
7.3 邻接矩阵与游走计数
邻接矩阵记录节点对是否相连。合成图按照A、B、C、D排序,行代表起点、列代表终点,数值1表示有边。在这一无权图中,邻接矩阵自乘会计算两步游走数。D到A的条目为1,因为存在D→C→A;A到A也为1,因为A→C→A返回起点。
游走可以重复访问节点,简单路径则不能。解释矩阵幂时必须区分:长度3的游走计数不只包含三条边的简单路径,还可能包含重复顶点和环。此外,混合不同关系类型的两步游走,未必有有用的语义解释。矩阵操作保存选定的代数结构,却不会自动赋予复合关系意义。
合成矩阵计算使用Wolfram的MatrixPower核验,目的在于教学:明确展示计算返回什么、哪些意义仍未确定。实际系统可用稀疏矩阵处理大型投影,但数值效率不改变解释。本报告不把游走计数当作概率、因果效应或独立证据数。
7.4 可复现的PageRank示例
PageRank为带随机跳转的随机游走计算平稳分布,最初用于网页排名[28]。只要明确转移的含义,同样的数学构造也可用于其他有向图。本例采用阻尼系数0.85,在四个合成节点间均匀随机跳转;每个节点将外出转移概率平均分给全部出边。本例不存在出度为零的悬挂节点。

式中,r为得分列向量,P为按行归一化的转移矩阵,v为均匀跳转向量。解线性系统可得A=0.3725268513、B=0.1958239118、C=0.3941492369、D=0.0375000000,合计为1。Wolfram LinearSolve独立返回相同结果,且有理数计算中的平稳方程残差严格为零[47]。报告的复现检查还包含本地数值计算。
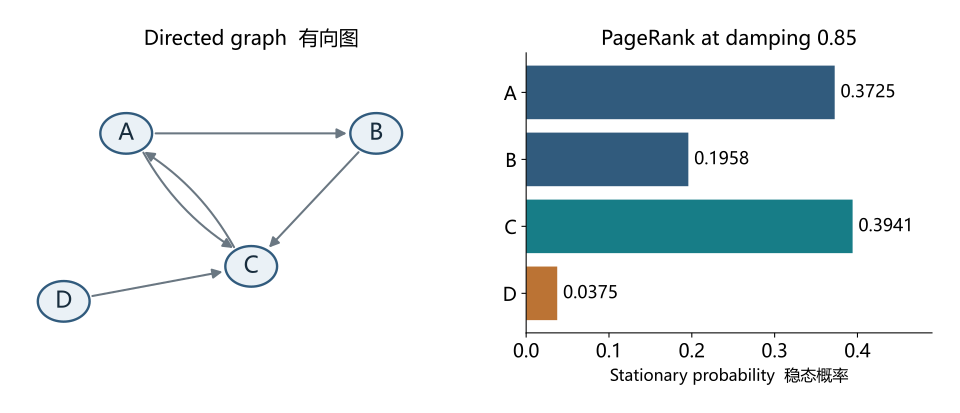
合成有向图及阻尼系数0.85时的PageRank分布。得分经Wolfram和本地线性系统计算核验,不是实证研究结果。
原图保留中英文标签;请结合正文解释阅读。点击可查看大图。C得分最高,是因为它接收A、B、D的转移;A则受益于C的出边。D没有入边,因此得分仅为随机跳转份额。这些是特定投影和转移规则的性质。若节点代表论文,分数表达的是模型下的结构显著性,不是实验有效性、方法严谨程度或研究的社会价值。
个性化PageRank调整随机跳转分布,以强调选定种子节点,可用于检索与用户问题相关的邻域。但结果仍对种子选择、关系过滤和图谱完备性敏感。节点低分可能因为数据库连接不足,而非现实中不相关。因此,覆盖不均时,检索系统应结合结构排序与词形或语义证据。
7.5 社区与相似度
社区发现按照结构目标把节点分组。Leiden针对Louvain可能产生的连接性问题作出改进,并在其形式化定义下提供保障[29]。社区可以将大型引用网络组织为便于浏览的区域,但区域标签仍需解释。社区可能反映方法、语言群体、历史时期或引用习惯,并不一定对应一致的科学主题。
分辨率设置与投影选择会改变分组,系统应报告这些选择,并检验在合理替代设置下解释是否仍成立。近似分组对探索浏览有用;若要据此论述学科结构,则需要更强验证。对照专家标签、考察边界案例和检查时间稳定性,可以判断算法是否找到了有用的分析单位。
相似度也依赖表示。在合成图的无向版本中,B的邻居为A和C,D的邻居为C,Jaccard相似度为1除以2,即0.5。它表示邻居集合的重叠,不是B与D应当相连的概率。链接预测模型可以将这种重叠作为特征,但转化成建议前还需要额外假设与验证。
7.6 表示学习与图神经网络
知识图谱嵌入将实体和关系映射为数值表示,使评分函数能够区分合理三元组。TransE用实体向量间的平移表示关系[21];ComplEx使用复数表示处理更多关系模式[23];RotatE则用复数空间中的旋转表示关系[24]。不同模型具有不同归纳偏置,数据中存在的关系模式影响哪些假设有用。
一个合成例子可说明评分思想。设实体向量为(1,0),关系向量为(0,1),两个候选目标分别为(1,1)和(3,1)。采用欧氏距离的TransE评分时,第一个候选距离为0,第二个为2,因此在所选几何空间下,第一个得分更有利。这些向量为解释而人工设置,并非从数据学习,不能证明预测准确性。
图神经网络通过组合邻居节点和边的信息更新表示。R-GCN利用依赖关系类型的变换,将图卷积扩展到关系数据[25];NBFNet受广义Bellman–Ford形式启发,构建可学习的路径框架[26]。这些方法说明拓扑和关系语义如何进入学习,但仍需在实际部署条件下评价,尤其要考虑训练后出现新实体或关系类型的情形。
7.7 复现与解释限制
分析结果应包含图快照、投影、算法版本、参数、适用时的随机种子,以及结果解释。近似算法还应记录容差与收敛标准,学习模型则应记录训练数据、负采样、验证政策与模型检查点。这些细节使其他分析者能够判断结果变化来自新知识、建模选择,还是数值变动。
图计算最有力的用途往往是缩小人工或自动调查范围,例如确定检查优先级、暴露断开记录、识别依赖或排序候选证据。系统明确自己解决的问题后,计算职责才更清楚。图分数应带着明确解释和经过测试的决策规则进入应用,而不能仅因它是在知识图谱上算出来的就获得权威。