10.1 互补的表示形式
大语言模型在参数中表示从训练数据学到的规律,知识图谱则通过标识、关系和情境明确表示选定信息。二者支持不同操作:语言模型理解灵活问题并生成可读文本,图谱支持精确身份、结构约束与可追溯更新。当应用既需要语言灵活性,又需要明确控制证据时,结合才有价值。
Pan等人概括了统一语言模型和知识图谱的方向,包括图谱增强语言模型、语言模型辅助图谱任务,以及更紧密的联合整合[35]。本报告采用这一宽泛区分,但聚焦操作问题:接口传递什么信息,原有保障在转换后还保留多少?将精确图结果转成文字可能丢失限定,将文字转成图记录则可能引入无依据的精确性,两个方向都需要验证。
10.2 检索增强生成
检索增强生成以检索到的外部信息作为答案条件。Lewis等人的代表方法将检索与序列生成结合,用于知识密集任务[34]。应用可以通过检索更新模型可用证据,而无需修改所有参数,但检索本身不保证事实性:系统可能找到无关材料、漏掉决定性来源,或生成超出证据的答案。
常规文本检索可以是有力基线:搜索文档块、重排候选,再将选中段落交给语言模型。如果定义在一份文档中已明确写出,图谱可能增益很小;若答案依赖跨文档实体连接、类型化关系或更大范围证据汇总,图检索才更有吸引力。工作负载应决定额外结构是否值得构建与维护。
10.3 GraphRAG的多种设计
GraphRAG是一族设计,而非单一且普遍规定的算法。系统可以从已有图谱检索显式三元组,从文档建图,用社区作摘要,或结合图神经表示与文本证据。这些变体的构建成本、查询行为与失效方式各异。研究比较应说明评价的是哪种架构,不能把所有图增强系统视为等同。
Edge等人提出面向查询的图摘要方法,通过抽取图和社区摘要回答针对整个语料库的问题[36]。它处理的需求不同于查找单一局部事实,说明预计算摘要为何可能帮助全局问题,同时也把建图与摘要维护计入系统成本。本报告不据此推断所有事实问题都受益于全局社区摘要。
LightRAG结合图结构与不同层级的信息检索机制[41];G-Retriever研究文本图上的检索增强生成[39];LEGO-GraphRAG通过模块化组件和实证比较分析图检索[42]。这些研究共同支持仔细拆解流程:每个组件都可能改善某一维度,同时增加延迟、词元消耗,或对所建图谱质量的依赖。
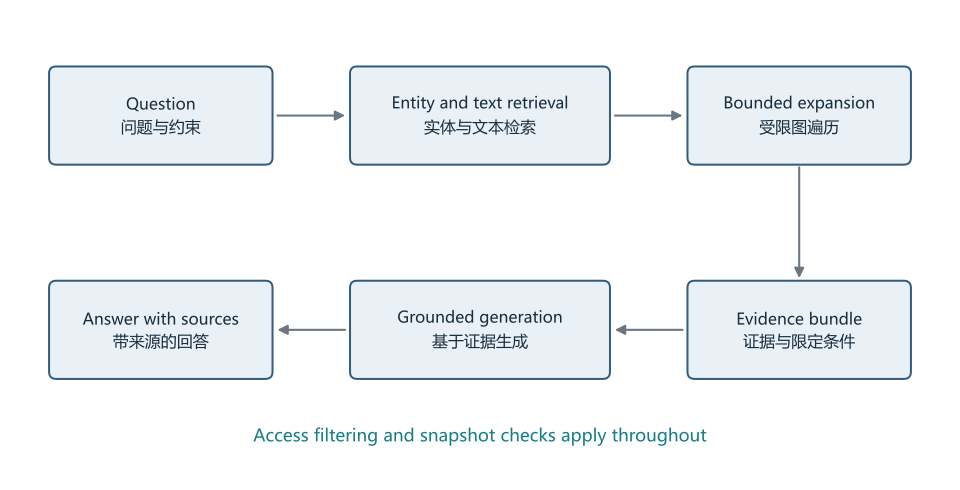
建议的混合GraphRAG流程。有界图扩展后,将来源证据与限定条件传入生成器。
原图保留中英文标签;请结合正文解释阅读。点击可查看大图。10.4 建议的混合检索流程
建议的研究证据图谱助手先解释问题,识别方法、数据集、日期和证据标准等约束,再通过精确标识、别名、词形搜索和语义检索生成候选实体。候选消歧必须明确:若GraphLens对应多个实体,系统不能悄悄选一个,而应利用语境区分,或提出范围明确的澄清。
选择种子后,检索器按关系类型白名单,在深度与结果数量上设限。针对实验支持的问题,沿评价与来源主张检索,而非任意扩展共同作者关系;同时收集结构记录与支持段落。证据包应含标识、来源版本、相关限定与访问决策,作为答案生成的依据。
重排器可以按相关性和完整性排序,但答案政策应保留冲突结果。若最高排名研究支持主张,另一项有效研究却反对,遗漏后者的摘要可能误导。系统可以为分歧和不确定性预留部分上下文预算;这是需要测试的应用设计,不能假设相关性模型自动找到恰当科学平衡。
10.5 全局问题与摘要维护
“这批文献主要有哪些方法分歧?”需要跨多文档综合。社区摘要是一种中间表示,每次查询时比检查全部原文更省成本,但其价值取决于社区与摘要是否保留相关区别。按引用接近性形成的群组,未必对应用户关心的分歧,因此可能需要多种组织视图或针对查询的聚合步骤。
摘要应带有到输入的来源和依赖连接。来源变化时,系统将受影响摘要标为过时;同时不能把摘要与底层来源算作独立证据。摘要是派生产物,不是另一项研究。多层检索若无明确谱系,很容易无意中放大证据数量。
即使图谱很大,上下文窗口仍是有限资源。检索所有邻居可能让生成器被大量弱相关信息淹没。有界证据选择应考虑答案要求、支持的多样性和矛盾覆盖。更多检索词元不一定意味着更多知识,也可能掩盖关键证据,增加混合不兼容情境的机会。
10.6 忠实性与公平比较
忠实性判断答案是否获得所提供证据的支持,正确性判断答案是否符合任务参考标准。二者可能分离:答案可能碰巧正确却无依据,也可能忠实总结了错误来源。研究助手应同时评价两者。出现引用并不够,被引段落必须支持其对应的具体陈述。
公平比较应尽量固定语言模型、来源集合、日期截止点和答案预算,在不同问题类别上比较文本检索、混合文本检索、图检索与社区摘要变体。局部事实、多来源、时间问题与全局综合应分别分析,否则总体平均可能掩盖某类显著改善与另一类退步。
成本应包含建图、更新和查询。首次查询前投入很大的系统,在稳定语料和大量重复问题下可能划算;在快速变化、查询很少的集合中则可能昂贵。只报查询延迟会掩盖差别。合适设计是在实际生命周期成本内达到所需证据质量,而非拥有最复杂检索示意图的设计。