4.1 明确关系究竟断言什么
关系抽取判断来源是否表达了特定论元之间的某种关系,论元可以是实体、事件、数量或主张。它不同于寻找彼此靠近的两个术语。“GraphLens与PathSearch进行了比较”支持比较关系,不代表谁优于谁;“作者希望GraphLens提高召回率”表达意图或假设,不是观察结果。用于证据性回答的建图系统必须保留这些区别。
关系集合应规定论元类型、方向、含义和证据要求。USES_DATASET连接实验与数据集,AUTHORED_BY连接文档与人物,REPORTS连接文档与主张。SUPPORTS和CONTRADICTS则需要更谨慎解释,因为支持通常有条件:研究可能支持主张的一方面,同时挑战另一方面。模式应精确表示被评价的主张,或使用带限定的评价对象明确评估维度。
关系方向并非外观选择。论文引用边反转,会改变引用数和遍历解释;供应关系反转,会改变供应风险分析。指南应包含逆向句式:“数据集D被实验E使用”与“实验E使用数据集D”,规范化后应形成相同方向的关系。图形可视化中,连接对象看起来仍合理,因此方向错误容易被忽略。
4.2 句子级与文档级抽取
句子层面的分类器针对一句话中的一对提及预测关系,可以利用周围词语与语法结构。证据局部、模式范围较窄时,这种设置有用。但若论元在别处引入、实体被代词替代,或关系依赖连续陈述,逐句独立处理便会丢失正确解释所需的信息。
DocRED面向文档级关系抽取,包括需要跨句整合信息的情况[18]。其一般启示是:推断单位可以大于提及检测单位。在虚构案例中,一段介绍GraphLens为提出的方法,另一段引入数据集D,结果表再报告得分,因此已接受的Evaluation可能需要多个位置的证据。仅给出一句话的定位,会造成证据已经完整的错误印象。
联合抽取模型在实体识别与关系预测之间共享信息。可能的USES_DATASET关系可帮助区分数据集名与方法名,实体类型则约束合理关系标签。SpERT和DyGIE++展示了通过上下文化表示连接任务的方式[16, 17]。耦合可以提高一致性,也可能传播早期错误,因此应同时检查最终关系与它依赖的论元身份。
生成式抽取将关系输出表示为序列,REBEL是把关系抽取作为语言生成处理的代表[19]。这类方法可以从段落生成多个三元组,不必为每对候选配置单独分类器。操作难点在于区分“结构合法”与“忠实抽取”:语法正确的三元组仍可能增加来源未表达的关系,遗漏限定条件,或使用非规范实体标签。解析只是验证的起点。
4.3 否定 情态与范围
否定改变陈述含义,其作用范围却未必容易确定。“研究未发现M提高召回率的证据”不等于“M降低召回率”,也不同于“M从不提高召回率”。只存正边或负边会丢失这些差别。研究证据图谱保存被报告的主张、极性、情态和评价情境,接受后的措辞应仍贴近来源,使审核者能够核查解释。
情态涉及可能、必要、意图、预期与条件。“M可能降低成本”表达可能性;“M必须使用参数P运行”表达要求;“若数据集平衡,M提高精确率”则有明确条件。遗漏情态词,会把试探表达变成强事实断言。实际测试集应刻意覆盖这些结构,不能只奖励简单肯定句。
量词同样重要。“一些研究报告改进”与“所有研究报告改进”不能存成同一种关系。前者可能由一项研究支持,后者则依赖被定义的总体与检索完备性。比例主张需要分母;若来源未规定总体,图谱应保留范围尚未明确的主张,而不是制造全称判断。
时间范围可能造成表面矛盾。旧年报中的“机构N主持项目P”,可以与后来记录的另一主持机构同时成立。抽取阶段应先捕获日期和来源情境,再由协调政策选择当前视图;否则,后续合并可能抹去历史关系,或错误地将某份报告判为不真实。历史查询与当前查询都受益于保留原始陈述。
4.4 监督与标注策略
有监督抽取需要反映目标领域的标注示例。有效记录应标识论元、关系类型、证据片段、限定条件与不确定性,并区分“未表达”“以否定方式表达”和“无法判断”。特定模型最终可能合并某些类别,但参考数据保留这些区别,能支持更好的错误分析,也有助于解释人工标注分歧。
远程监督利用已有数据库关系自动标注文本。Mintz等人的代表方法将已知关系与文本中的共现对齐[20]。其吸引力在于规模:现有结构化知识可生成大量训练例。然而假设并不完美,同时提及两个实体的句子可能谈的是另一种关系。因此,应用流程应把这些标签视为含噪训练证据,而非经过验证的金标准。
弱监督可以组合规则、词典、已有数据库和模型预测。合理项目先为定义明确的关系建立高精确率模式,再识别模式遗漏的内容;人工审核集中处理标注来源分歧或新关系类型。这样,标注投入能响应系统的实际失效方式,也能避免把自动标注数据量大误认为概念覆盖必然广。
主动学习选择预计能改进模型或解决重要不确定性的示例。在研究证据图谱中,涉及比较措辞和多个基线的例子可能尤其有价值,因为这些错误影响核心应用。但不能只依据不确定性分数,否则会漏掉自信却错误的模式。混合不确定、多样与随机示例,可以形成更有信息量的审核集合。
4.5 建议的接受契约
候选关系进入已接受图谱之前,建议系统检查论元是否存在、类型是否兼容、关系是否属于模式,以及来源定位能否解析;随后检查措辞是否保留否定、时间与必要限定。这些检查不必全部交给一个模型:确定性验证处理标识和数据类型,独立模型或人工审核判断语义忠实性。结果应记录实际执行了哪些检查、哪些仍未解决。
比较结果采用更严格的接受契约:必须包含被比较的方法、数据集版本、指标定义与报告结果。若来源只说某方法“更好”,可以存为归属于来源的定性主张,但不能虚构数值提升。若表格报告多个指标,图谱应将各项指标观测分别连接到同一Evaluation,而非只挑最有利的一项。
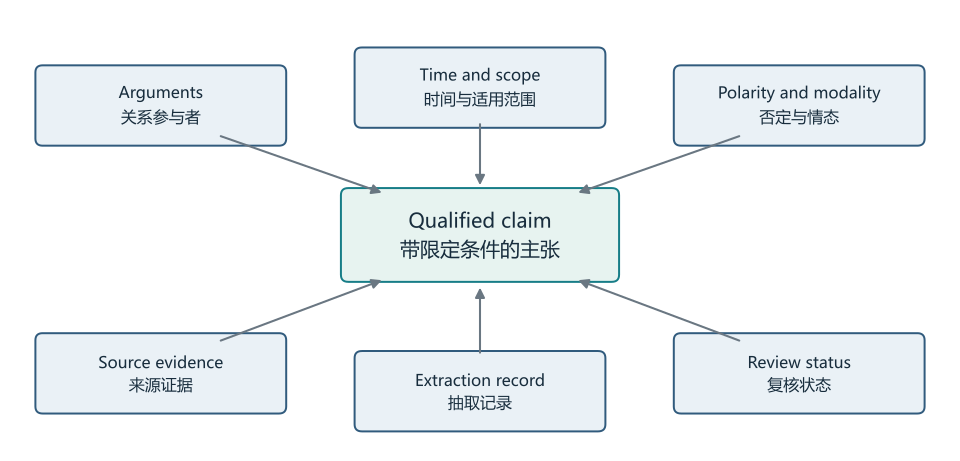
主张需要主语与宾语以外的情境。本图总结报告建议的接受记录。
原图保留中英文标签;请结合正文解释阅读。点击可查看大图。图谱应保留抽取与相互印证的区别。两份文档可能重复同一个缺乏依据的断言,不能将两份记录当作独立确认。引用、共用数据集、复制文本与共同作者身份,有助于识别依赖,但任何一项都不是完美的独立性检验。界面应显示证据链,让审核者检查表面分开的来源是否实际出自同一研究。
4.6 衡量有用的抽取质量
关系精确率考察预测关系中有多少符合标注政策,召回率考察参考关系中有多少被恢复。端到端计分应要求论元身份、方向、标签,以及任务必需的限定条件都正确;诊断分数则可逐项放宽要求,从而区分“关系理解正确但实体边界略有偏差”与“自信地反转实验结果”等不同错误。
证据质量值得单独评价。一条关系即使碰巧真实,其引用段落也可能并不支持它。研究助手必须接受“证据是否实际蕴涵或足以支持报告陈述”的评价。人工审核可标记证据充分性与缺失情境。部署时,小而有充分依据的关系集合,可能比召回率漂亮却难以追溯证据的大图谱更有价值。