5.1 把构建视为迭代过程
知识图谱构建通常是持续进行的获取、协调、验证与修订过程。Zhong等人将知识获取、精炼与演化视为自动构建的重要部分[3]。这一视角很有用,因为图谱很少能在单次导入后一直正确:来源会变化,抽取器会改进,用户会发现错误。预先考虑修订的设计,能将变化变成例行维护,而不是反复从头重建。
建议流程从来源清单开始,为每个来源分配标识、拥有者、访问政策、格式、更新周期和允许用途。内容哈希识别精确文件版本,元数据记录获取日期与原始位置。原始来源与抽取文本分别保存,便于判断错误来自原文、文本转换、模型解释,还是后续协调。
解析产生章节、段落、表格、图注和参考文献等结构单元,分块再形成处理单元,同时保留回到文档结构的连接。块大小应服从任务:实体检测可能只需局部语境,解释结果却可能需要方法章节和表注。重叠分块有助于保留语境,却会产生重复候选,因此合并政策应识别多次抽取可能来自同一底层段落。
5.2 区分暂存候选与已接受知识
暂存区在接受前保存候选实体与主张,主图谱则提供符合当前接受政策的记录。这让系统能够保留不确定输出,而不把它们呈现为既定知识。被拒绝的候选可在适当留存控制下用于调试;暂存区应记录拒绝理由,使团队能够区分格式不合法与语义缺乏依据。
每次抽取运行都应使用版本化配置,包含模型、提示、模式版本、解析器、分块器与相关参数。使用新模型重新处理同一文档,应形成一次新运行,而非悄悄替换旧记录。系统可以比较输出并决定接受哪些变化。当模型更新提高召回率却引入新型误报时,这尤为有用;若缺少运行层面的溯源,图谱变化就很难解释。
幂等性意味着重复执行导入不会产生非预期重复。实用键可以组合文档版本、来源片段、关系类型、规范化论元与抽取政策,但键必须反映记录语义:同一文档中的两个独立实验,不能仅因使用相同方法和数据集就被合并。因此,幂等性既需要技术标识,也需要明确什么才算同一断言。
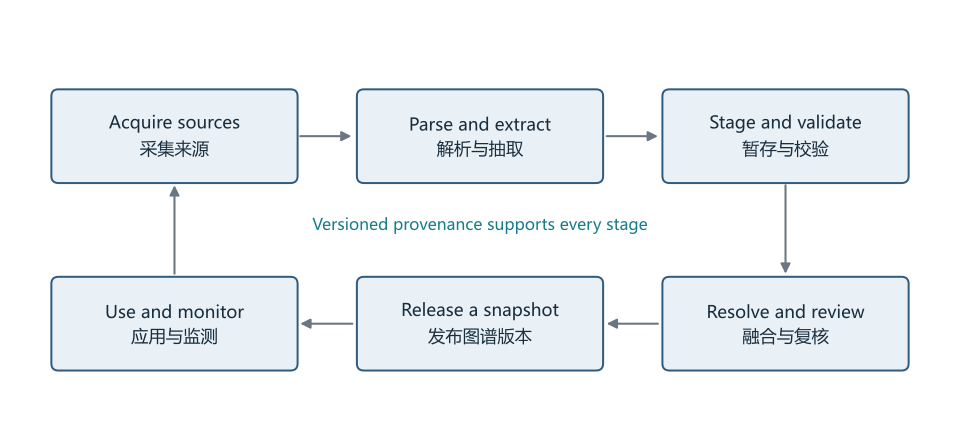
知识图谱生命周期包含修订与监测,每次转换都由溯源与版本管理支持。
原图保留中英文标签;请结合正文解释阅读。点击可查看大图。5.3 融合 冲突与审核
知识融合在组合不同来源信息时保留出处。即使发表年份这样的简单属性,也可能因预印本、在线发表和卷期日期不同而冲突。解决政策应先确定应用需要哪类日期,而不是挑选出现最多的值。对于依赖来源的属性,图谱可以保留多个带限定的值,再针对特定视图给出首选值。
去重应区分重复报道与独立证据。期刊论文及其预印本可能是同一研究的不同版本,综述可能只是总结该研究,社交媒体又转述综述。如果把三者计为三项独立支持研究,就会制造共识的假象。建模出版谱系与证据源头有助于避免错误,但含糊情况仍可能需要人工审核。
人工审核应有明确范围。审核者可以确认抽取忠实于来源,却不认可来源的科学结论;另一审核者则可能评价方法质量。系统应把它们记录为不同活动,否则笼统的“已审核”标签容易被下游过度解释。同理,通过数据类型验证不等于通过科学可靠性审核。
5.4 更新 删除与修复
增量更新应识别哪些派生记录依赖变化的来源。文档更正后,其主张、摘要、嵌入与缓存答案都可能需要修订。依赖图可以追踪这些关系,使图谱本身成为维护机制的一部分,告诉系统哪些输出可能已经过时。依赖应在产物创建时记录,因为事后重建往往不可靠。
删除政策必须覆盖原文、抽取表示、备份与派生产物。删除原始文件,却让文本继续保留在嵌入存储中,并未真正从系统移除信息;删除主张,却保留重复该主张的社区摘要,也可能继续误导用户。修复应传播到全部相关表示,并记录传播状态。
失败的更新不应让已接受图谱停留在两个版本之间。小规模关联修改可以使用事务,大型导入则可能先暂存发布,在验证后切换活动快照。选择依赖数据库能力与数据量。关键是让用户能够识别正在查询哪个一致版本;明确的快照标识往往比首页模糊的“最近更新”时间更有信息量。
5.5 将构建作为可测量服务
流程监测应包含来源新鲜度、抽取覆盖率、未解决身份、验证失败、审核积压和修复时间,反映系统是否履行知识维护责任。仅看节点和边数量很弱:边数增长既可能来自有效丰富,也可能来自重复导入或模型过量生成推测关系。操作指标应关联模式设计时确立的能力问题。
建议服务为每个图谱版本发布简短说明,列出变化来源、接受与拒绝的断言、模式变化及已知限制。个人项目可以是一份文件,组织系统则可接入仪表盘和审计。目的是使知识维护可见且可重复,让对图谱的信任建立在可观察实践上,而非抽取模型看起来多么先进。